제품 보안 인증(RED·CRA 등)을 준비하다 보면 영문 규격·가이드 문서를 자주 읽게 됩니다. 분량은 많고 보안 전문 용어도 빡빡한데, 범용 번역기는 그 용어를 어설프게 옮기거나 내부 문서를 외부 서버로 보내야 한다는 점이 늘 걸렸습니다. 그래서 “보안 도메인을 잘 알고, 우리 안에서 돌아가는 번역기가 있으면 좋겠다”는 생각에서 이번 작업을 시작했습니다.
1. Local LLM 선택의 기본기 — 하드웨어와 양자화
Local LLM을 현업에 도입할 때 마주하는 첫 번째 제약은 언제나 GPU 메모리(VRAM)입니다.
모델 원본을 그대로 메모리에 올리면 VRAM이 부족해 프로세스가 멈추거나 터지는(OOM) 경우가 매우 흔합니다. 따라서 모델을 도입하기 전에 양자화(Quantization)와 FP16 / 4-bit 압축 전략을 가장 먼저 검토해야 합니다.
LLMFIT은 수백 개의 LLM 모델·제공자 중에서 내 시스템(RAM·CPU·GPU) 으로 실제 실행 가능한 모델을 한 번의 명령으로 찾아주는 도구입니다.
하드웨어에 맞는 모델을 고르는 첫 단계에서 큰 도움이 됩니다. 설치와 사용도 간단합니다.
brew install llmfit
llmfit
각 모델의 예상 처리 속도(tokens/s), 양자화 형식, 메모리 사용량, 컨텍스트 길이, ‘Perfect/Good/Marginal/Too Tight’ 적합도까지 한눈에 보여줍니다.
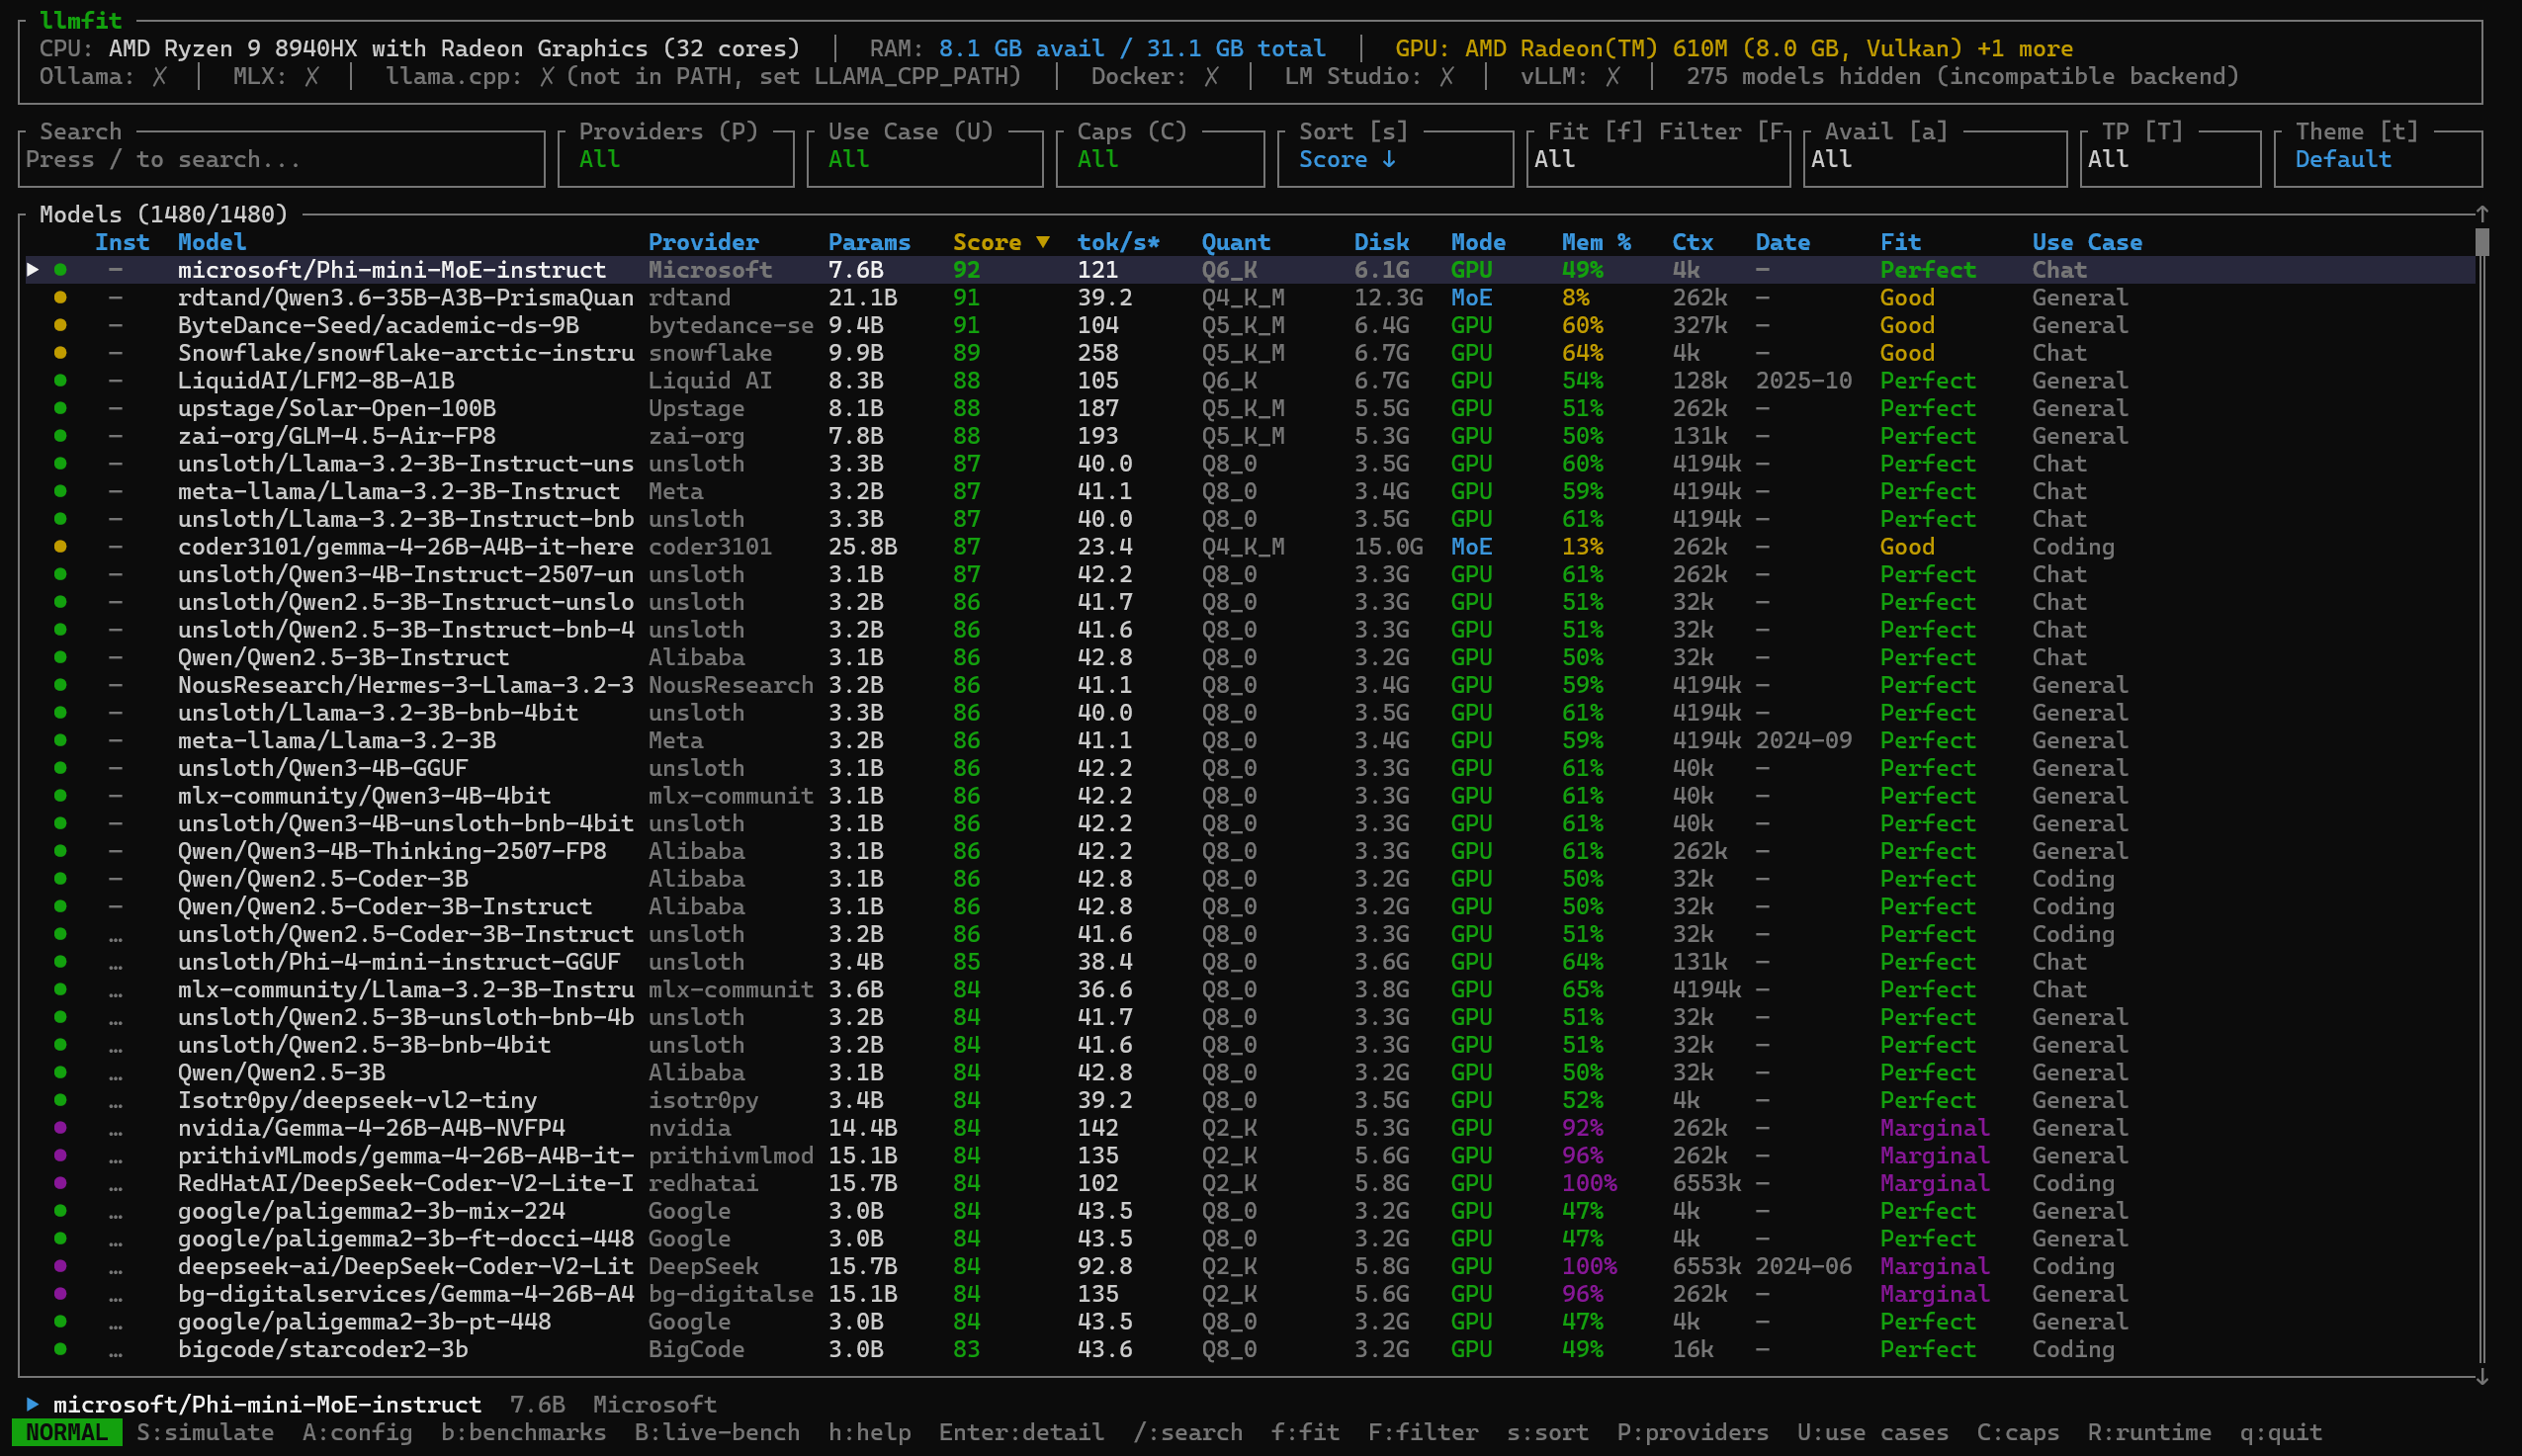
참고사항
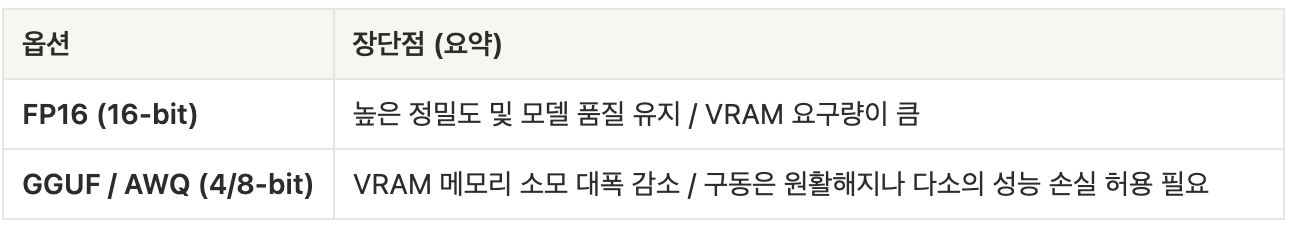
FP16(반정밀도): 정밀도와 품질 면에서 가장 훌륭하고 무난하지만, VRAM 요구량이 높습니다.
GGUF / AWQ (4-bit/8-bit): 모델 크기를 1/3 수준으로 대폭 압축하여, VRAM이 적은 환경(노트북 등)에서도 실제 운용이 가능하도록 한계를 확장해 줍니다.
1.1 모델 압축 옵션 비교
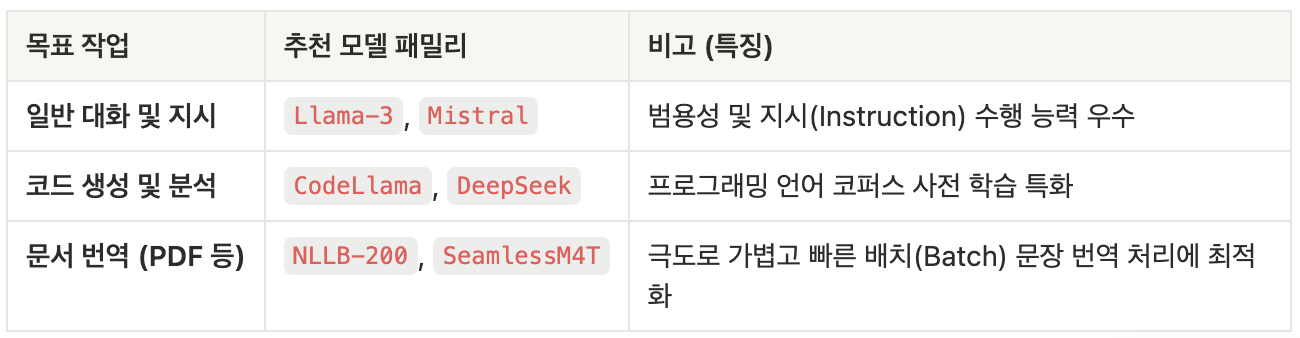
1.2 태스크별 추천 모델 패밀리
2. 우리의 선택 — 목표와 NLLB-200(600M)
목표는 분명했습니다. 팀원 누구나 외국어 문서를 빠르고 정확하게 번역할 수 있는, 레이아웃까지 그대로 유지되는 PDF 번역 웹 서비스를 만드는 것이었죠. 다만 조건이 까다로웠습니다. DeepL 같은 외부 API는 문서가 밖으로 나가는 데다 종량제 비용도 부담이라 쓸 수 없었고, 그렇다고 기존 Ollama 기반 범용 LLM으로는 번역 속도와 하드웨어 효율이 따라주지 않았습니다.
그래서 택한 답이, 오직 번역만을 위해 설계된 메타(Meta)의 다국어 특화 모델 NLLB-200(No Language Left Behind, 200개 언어) 을 완전히 로컬(On-Premise)에 올리는 것이었습니다. 데이터 보안과 처리 속도를 동시에 잡는 선택이었죠.
2.1 왜 NLLB-200(600M)인가
목적 부합성: 범용 LLM(Llama 등)과 달리 오직 텍스트 번역만을 위해 훈련되어, 적은 파라미터로도 매우 뛰어난 번역 품질 제공.
하드웨어 가성비: 600M 모델은 VRAM 소모가 1GB 이하로 매우 가벼워, 노트북 환경(RTX 5060, VRAM 8GB)에서도 동시 번역(Concurrency) 수를 4~16까지 무리 없이 올려 강력한 병렬 처리 속도를 낼 수 있었습니다. (필요하면 1.3B·3.3B 모델로 교체할 수 있도록 확장성도 확보했습니다.)
Tip. 너무 최신 GPU(RTX 5060 등 Blackwell
sm_120)에선 PyTorch 기본 빌드가 실행을 거부할 수 있습니다 — NVIDIA 드라이버·PyTorch를 최신으로 맞추고, 모델은.bin대신safetensors로 로드하면 대부분 해결됩니다.
3. 구현 — PDF 번역 파이프라인
3.1 PDF 레이아웃 보존 엔진 (PyMuPDF)
단순히 텍스트만 긁어오지 않고, PDF 안의 Block(문단)이나 Line(표 헤더 등) 단위로 좌표까지 추적해 추출합니다. 이렇게 얻은 위치 정보를 바탕으로 번역된 텍스트를 원본의 같은 좌표에 다시 얹는데, 이때 글자가 칸을 넘치지 않도록 폰트 크기를 자동으로 계산(Overflow 방지)해 덧입힙니다. 그래서 번역 후에도 원본 레이아웃이 그대로 유지됩니다.
3.2 비동기 병렬 번역 엔진 (FastAPI + asyncio)
여러 문장을 동시에 번역하되, GPU가 감당할 수 있는 만큼만 돌리는 게 관건이었습니다.
세마포어(Semaphore) 로 한 번에 번역하는 문장 수를 VRAM 한도 안에서 유동적으로 조절해 메모리 터짐(OOM)을 원천 차단했습니다.
또 하나의 복병은 토크나이저였습니다. Rust 기반 HuggingFace 고속 토크나이저는 여러 스레드가 동시에 접근하면 Already borrowed 충돌을 일으키는데,
threading.Lock() 으로 모델 추론(model.generate()) 구간만 직렬화해 충돌을 막고 안정적인 파이프라인을 완성했습니다.
3.3 보안 도메인 번역 사전 (Glossary)
범용 번역기의 가장 큰 약점은 보안 전문 용어를 엉뚱하게 옮긴다는 점입니다. 그래서 보안 도메인 전용 번역 사전을 별도로 구현해, 번역 과정에서 지정된 용어가 항상 같은 표현으로 치환되도록 했습니다. 예를 들어 attack surface, SBOM, threat model 같은 용어가 문맥에 휘둘리지 않고 일관되게 번역돼, 문서 전체의 용어 통일성과 정확도를 크게 끌어올렸습니다.
4. 결론
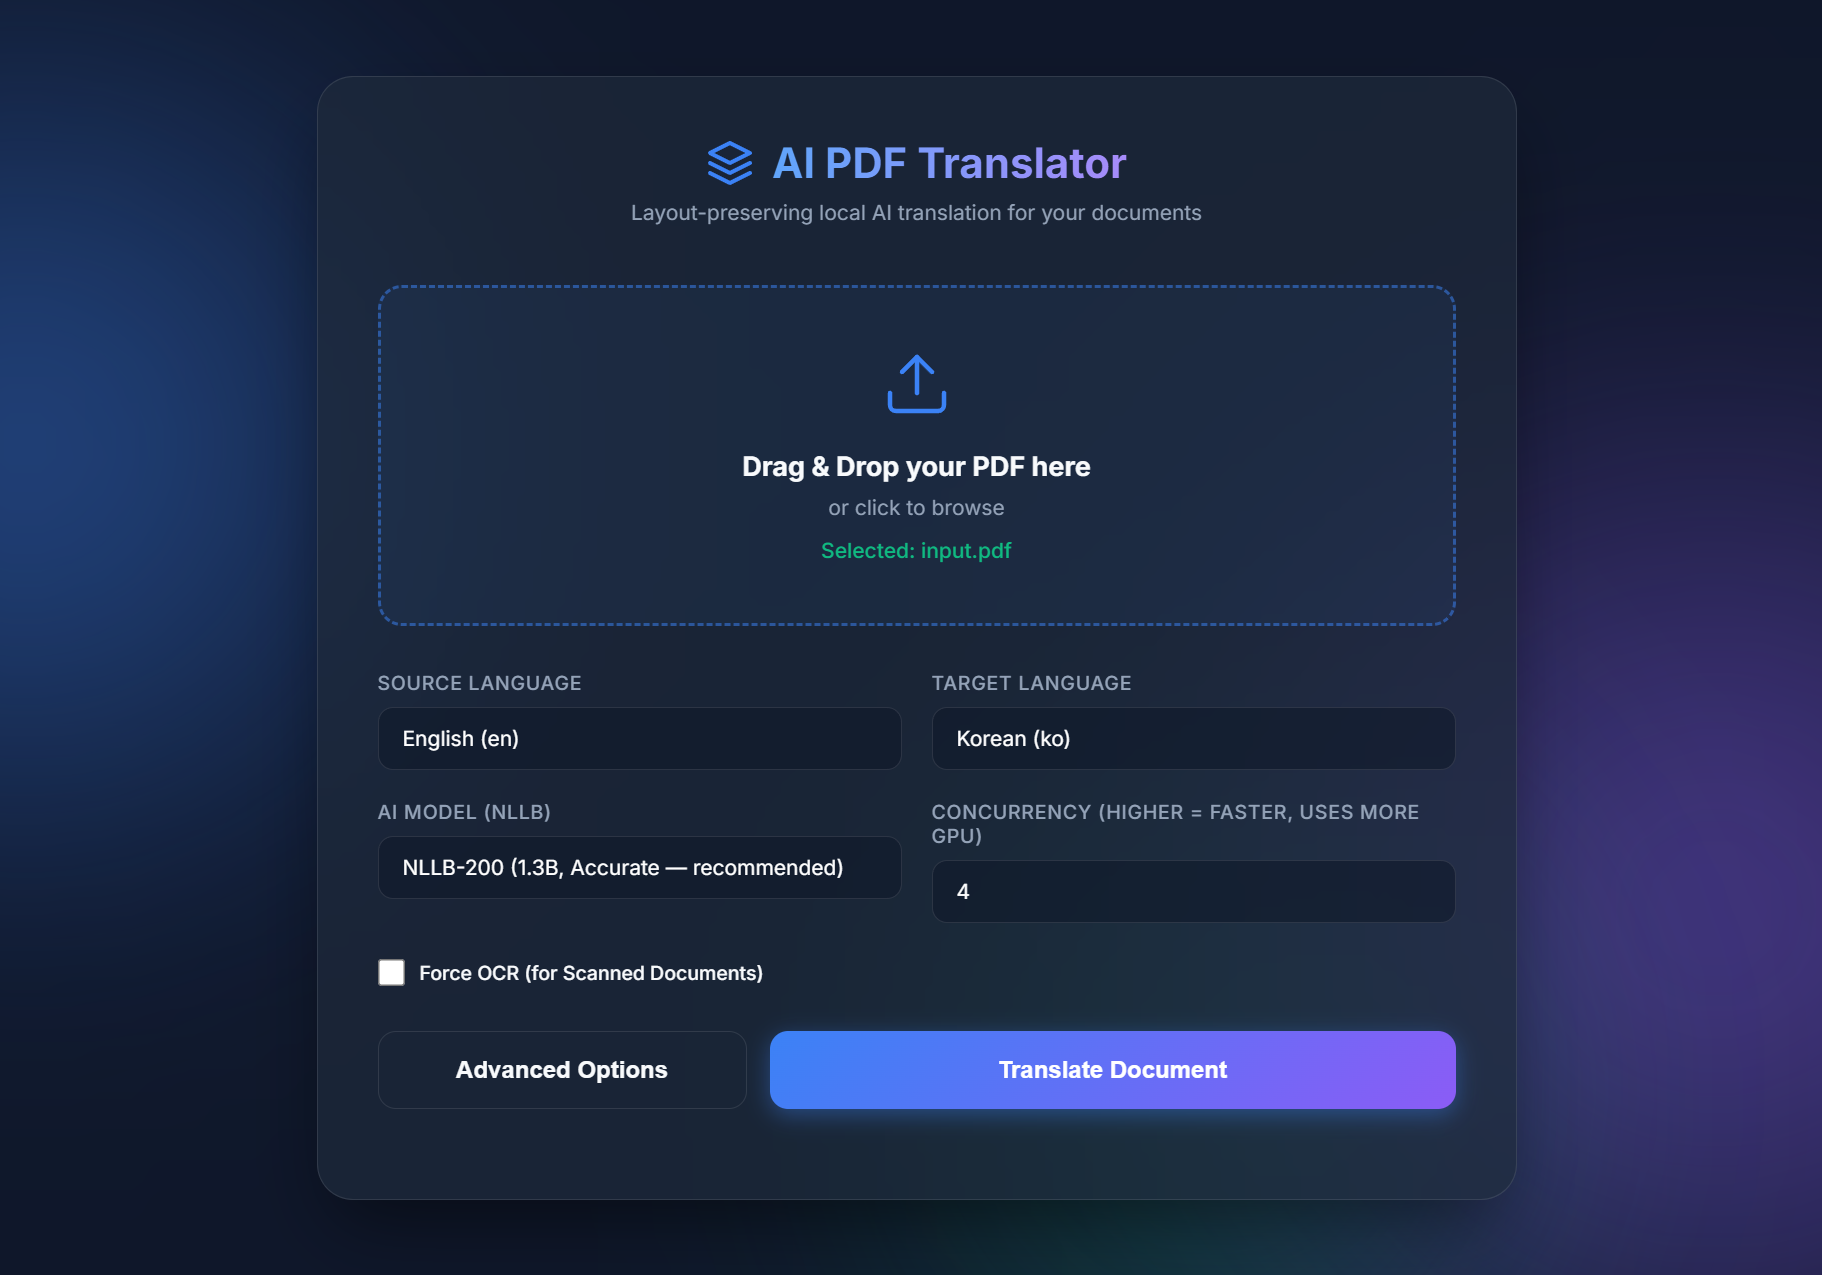
범용 LLM 시대에도 특정 태스크(번역)에 특화된 소형 로컬 모델(sLLM) 을 잘 튜닝하면, API 비용 없이도 실서비스에 충분한 성능을 낼 수 있음을 확인했습니다. 다음 단계로는 스캔 PDF를 위한 OCR(Tesseract 등) 연동과 보안 용어 사전 고도화를 염두에 두고 있습니다.
우리가 이번에 한 일은 '어떤 모델이 좋은가'라는 질문에 대해 정답을 찾기보다, '우리 환경에서 실제로 돌아가고 의미 있는 결과를 주는 조합은 무엇인가'를 찾는 과정이었습니다. 작은 실험과 자동화된 탐색이 현실적인 결정을 도와줍니다.
비슷한 환경에서 Local LLM 도입을 고민 중이라면, 이 글의 선택 기준과 구현 기록이 작은 출발점이 되길 바랍니다.